Скидка 5% на первый заказ — RDS5




Архитектура базы данных postgresql
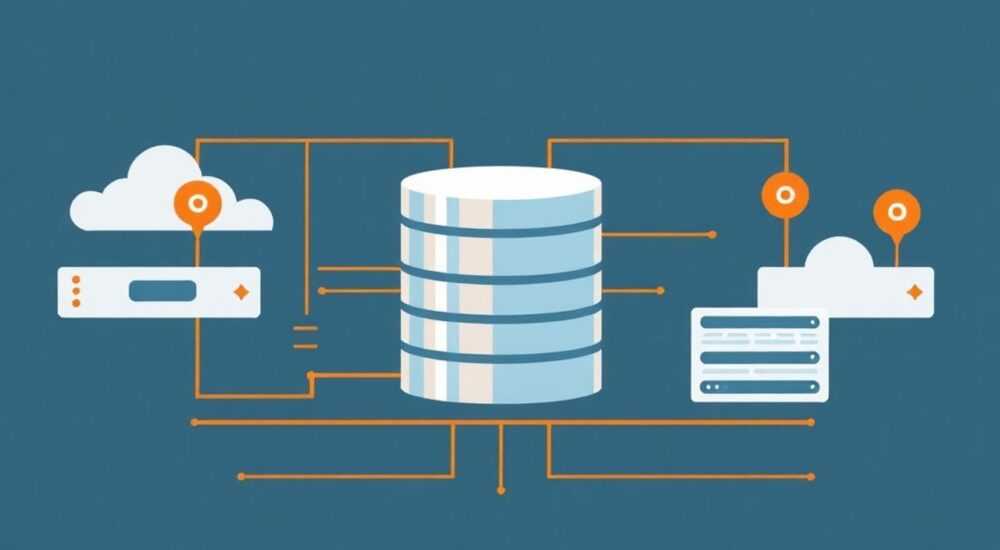
PostgreSQL — одна из самых надёжных и мощных систем управления реляционными базами данных с открытым исходным кодом. Её архитектура сочетает в себе высокую производительность, масштабируемость и поддержку современных требований к данным. В основе PostgreSQL лежит процессно-ориентированная модель, обеспечивающая стабильность и отказоустойчивость даже при интенсивной нагрузке.
Архитектура PostgreSQL построена на процессной модели, где каждый клиентский запрос обрабатывается отдельным процессом. Это обеспечивает изоляцию и безопасность, но требует грамотного управления ресурсами. Оптимальная настройка параметров, таких как shared_buffers и work_mem, критически важна для высокой производительности.
Содержание статьи:
- Общая архитектура PostgreSQL
- Процессная модель: как работает сервер
- Как создаётся подключение
- Структура хранения данных
- Формат строки и видимость
- Контроль транзакций и MVCC
- Проблемы при неправильной настройке autovacuum
- Обработка запросов и оптимизация
- Как улучшить производительность запросов
- Индексы и их влияние на производительность
- Современные возможности: частичные и выражения
- Репликация и высокая доступность
- Режимы репликации
- Экспертное мнение
- Вопросы и ответы
- Заключение
Общая архитектура PostgreSQL
PostgreSQL использует клиент-серверную архитектуру, где серверный процесс (postmaster) управляет всеми входящими соединениями и координирует работу фоновых процессов. Клиентские приложения подключаются через стандартные протоколы, такие как TCP/IP или Unix domain sockets, и отправляют SQL-запросы на выполнение.
Сервер состоит из нескольких ключевых компонентов: процесс postmaster, процессы-воркеры, процессы записи WAL, автовакуум, а также фоновые задачи, отвечающие за контроль целостности и производительности. Архитектура спроектирована так, чтобы минимизировать блокировки и обеспечить максимальную параллельность операций.
Основное внимание уделено надёжности данных. Все изменения записываются в журнал предзаписи (Write-Ahead Logging, WAL), что позволяет восстанавливать состояние базы после сбоев. Это делает PostgreSQL особенно привлекательным для систем, где данные критичны.
Полезно знать: PostgreSQL не использует потоки, а полагается на отдельные процессы для каждого подключения. Это повышает стабильность, но может увеличить потребление памяти при большом числе соединений.
Процессная модель: как работает сервер
Центральным элементом архитектуры является главный процесс postmaster, который запускается при старте СУБД. Он отвечает за прослушивание портов, принятие новых подключений и создание дочерних процессов для обслуживания клиентов.
Каждое новое соединение порождает отдельный backend-процесс. Этот процесс полностью изолирован от других и обрабатывает все запросы конкретного клиента. Изоляция обеспечивает стабильность: сбой одного процесса не затрагивает остальные.
Фоновые процессы играют ключевую роль в работе системы:
- writer — записывает «грязные» страницы из shared_buffers на диск;
- wal writer — регулярно сбрасывает записи WAL;
- wal receiver — принимает данные при репликации;
- autovacuum launcher — запускает процессы очистки мёртвых строк.
Такой подход исключает общие точки отказа и позволяет эффективно использовать многоядерные системы. Однако он требует внимания к настройке параметров, связанных с памятью и количеством подключений.
Как создаётся подключение
- Клиент инициирует подключение к порту 5432 (по умолчанию).
- Postmaster проверяет учётные данные и права доступа.
- Если всё в порядке, создаётся новый backend-процесс.
- Процесс получает PID, выделяется память, и начинается обработка запросов.
«Не стоит пытаться обслуживать тысячи подключений напрямую — это быстро исчерпает ресурсы. Используйте пулы соединений, такие как PgBouncer.» — Алексей Петров, DBA, 12 лет опыта
Структура хранения данных
PostgreSQL хранит данные в виде таблиц, разбитых на страницы размером 8 КБ. Каждая таблица представляет собой набор блоков (страниц), которые физически размещаются в файлах на диске. Система каталогов ведёт учёт всех объектов базы.
Данные организованы иерархически: кластер → база данных → схема → таблица → строка. Кластер — это совокупность всех баз данных, управляемых одним экземпляром PostgreSQL. Файловая структура отражает эту иерархию: каталог base содержит подкаталоги для каждой базы, а внутри — файлы таблиц.
Каждая строка имеет уникальный идентификатор — TID (Tuple Identifier), состоящий из номера блока и смещения внутри него. Это позволяет быстро находить нужные данные без необходимости сканирования всей таблицы.
Формат строки и видимость
PostgreSQL использует формат хранения HEAPTUPLE, где каждая строка содержит системные поля: xmin, xmax, ctid и другие. Эти поля необходимы для реализации MVCC (многоверсионного контроля параллелизма).
xmin указывает на идентификатор транзакции, создавшей строку, а xmax — на транзакцию, удалившую её. На основе этих меток определяется видимость строки для текущей транзакции.
Поле |
Назначение |
|---|---|
xmin |
ID транзакции, создавшей строку |
xmax |
ID транзакции, удалившей строку |
ctid |
Физический адрес строки (блок + смещение) |
OID |
Опциональный уникальный идентификатор |
Полезно знать: OID можно отключить при создании таблиц — это экономит место. Используйте SERIAL или UUID вместо OID для первичных ключей.
Контроль транзакций и MVCC
MVCC — один из ключевых механизмов PostgreSQL, позволяющий обеспечить высокий уровень параллелизма без блокировок на чтение. Вместо блокировки строк при обновлении система сохраняет несколько версий одной и той же строки.
Когда транзакция читает данные, она видит «снимок» состояния базы на момент начала. Это достигается за счёт анализа xmin и xmax в сочетании с глобальной таблицей активных транзакций (ProcArray). Таким образом, читающие транзакции не мешают пишущим.
Операции UPDATE и DELETE не изменяют существующие строки, а помечают их как удалённые и создают новые версии. Это приводит к накоплению «мёртвых» строк, которые затем удаляются процессом VACUUM.
Проблемы при неправильной настройке autovacuum
- Рост объёма данных без реального увеличения информации;
- Замедление запросов из-за необходимости сканировать лишние строки;
- Риск переполнения transaction ID (XID wraparound), что может привести к остановке базы.
Автоматическая вакуумизация настраивается на уровне таблиц и может быть адаптирована под нагрузку. Например, таблицы с частыми обновлениями требуют более агрессивных значений autovacuum_vacuum_scale_factor и autovacuum_vacuum_threshold.
«Настройте autovacuum индивидуально для каждой нагруженной таблицы. Не полагайтесь только на глобальные параметры.» — Марина Соколова, архитектор баз данных, CloudDB Solutions
Обработка запросов и оптимизация
Когда PostgreSQL получает SQL-запрос, он проходит через несколько этапов: синтаксический анализ, семантическая проверка, планирование и выполнение. Планировщик (query planner) играет ключевую роль, выбирая наиболее эффективный способ получения данных.
Планировщик оценивает стоимость различных путей выполнения на основе статистики, собираемой командой ANALYZE. Эта статистика включает количество строк, распределение значений, частоту встречаемости и другие метрики.
Для сложных запросов могут использоваться:
- Последовательное сканирование (Seq Scan);
- Индексное сканирование (Index Scan);
- Bitmap сканирование — когда нужно объединить результаты нескольких индексов;
- Join-алгоритмы: nested loop, hash join, merge join.
Как улучшить производительность запросов
- Регулярно выполняйте ANALYZE, особенно после массовых изменений.
- Используйте EXPLAIN (ANALYZE, BUFFERS) для диагностики узких мест.
- Настройте work_mem в зависимости от объёма оперативной памяти и числа одновременных операций.
- Избегайте функций в условиях WHERE, если они не индексируемые.
Полезно знать: Чрезмерное увеличение work_mem может привести к исчерпанию памяти. Разумный лимит — 64–256 МБ на сессию в типичных средах.
Индексы и их влияние на производительность
Индексы в PostgreSQL — это отдельные структуры, ускоряющие поиск по таблицам. Наиболее распространённый тип — B-дерево, подходящий для диапазонных и точечных запросов. Также доступны GIN, GiST, BRIN и другие, оптимизированные под специфические случаи.
Выбор типа индекса зависит от типа данных и характера запросов. Например:
- B-tree — для чисел, дат, строк;
- GIN — для массивов, JSONB;
- BRIN — для больших таблиц с естественной упорядоченностью (например, по временным меткам).
Индексы требуют места на диске и замедляют операции вставки/обновления, поэтому их нужно создавать осознанно. Избыточные индексы — частая причина снижения производительности.
Современные возможности: частичные и выражения
PostgreSQL поддерживает продвинутые типы индексов:
- Частичные индексы — строятся только по части строк, отфильтрованных условием;
- Индексы по выражениям — позволяют индексировать результат функции (например, UPPER(name)).
Такие индексы особенно полезны в высоконагруженных системах, где важно минимизировать объём данных и максимизировать скорость.
«Перед созданием индекса спросите: какой запрос он ускорит? Если нет чёткого use case — скорее всего, он не нужен.» — Дмитрий Козлов, senior DBA, PostgresPro
Репликация и высокая доступность
PostgreSQL поддерживает логическую и физическую репликацию. Физическая репликация основана на передаче записей WAL и обеспечивает байт-в-байт копию основного сервера. Она используется для создания реплик чтения и обеспечения отказоустойчивости.
Логическая репликация позволяет реплицировать отдельные таблицы и преобразовывать данные. Это полезно при миграциях, шардинге или интеграции с другими системами.
Для автоматизации переключения между мастером и репликой применяются инструменты:
- Pgpool-II;
- Patroni;
- repmgr.
Режимы репликации
Режим |
Гарантии |
Задержка |
|---|---|---|
Asynchronous |
Высокая производительность, возможна потеря данных |
Низкая |
Synchronous |
Нет потери данных, выше задержка |
Высокая |
Quorum Commit |
Компромисс между надёжностью и скоростью |
Средняя |
Полезно знать: Синхронная репликация требует подтверждения от хотя бы одной реплики. Это снижает производительность, но гарантирует целостность данных.
Экспертное мнение
«Архитектура PostgreSQL — это баланс между простотой и мощью. Она не пытается быть всем сразу, но делает свою работу исключительно хорошо. Особенно ценю гибкость MVCC и богатый экосистемный инструментарий.» — Анна Волкова, технический директор, DataCore Labs, 15 лет в области СУБД
По её словам, ключ к успеху — понимание внутреннего устройства. «Многие администраторы настраивают PostgreSQL “по шаблону”, не вникая в смысл параметров. А между тем, даже такие настройки, как effective_cache_size или random_page_cost, сильно зависят от железа и нагрузки.»
Она рекомендует начинать с мониторинга: использовать pg_stat_statements, pgBadger и Prometheus + Grafana. «Только имея данные, можно принимать правильные решения. Интуиция — плохой советчик при оптимизации баз данных.»
Вопросы и ответы
Чем PostgreSQL отличается от MySQL по архитектуре?
PostgreSQL использует процессную модель и MVCC, тогда как MySQL (в InnoDB) — потоковую и блокировочную систему. PostgreSQL более строг к типам данных и поддерживает сложные типы (JSONB, массивы, диапазоны).
Нужно ли использовать SSD для PostgreSQL?
Да, особенно для систем с интенсивной записью. SSD значительно ускоряют операции I/O, что критично для работы WAL и индексов. HDD допустимы только в тестовых или малонагруженных средах.
Как избежать XID wraparound?
Регулярно выполняйте VACUUM, следите за возрастом транзакций (pg_xact_age()). При достижении 1 млрд транзакций требуется срочный vacuum full. Настройка autovacuum поможет предотвратить проблему.
Можно ли масштабировать PostgreSQL горизонтально?
Напрямую — сложно. Но с помощью логической репликации, Citus (расширение для шардинга) или внешних решений (например, YugabyteDB на основе PostgreSQL) — возможно.
Как выбрать значение shared_buffers?
Рекомендуется 25% от RAM, но не более 8 ГБ на системах до 32 ГБ. На более мощных серверах — до 12–16 ГБ, так как слишком большой буфер может снижать эффективность ОС-кеширования.
Заключение
Архитектура PostgreSQL — результат многолетней эволюции, направленной на создание надёжной, гибкой и производительной СУБД. Её процессная модель, MVCC, развитая система индексов и поддержка репликации делают её выбором №1 для множества проектов — от стартапов до корпоративных систем.
Понимание внутреннего устройства PostgreSQL позволяет не просто администрировать базу, а проектировать её эффективно с учётом нагрузки, требований к доступности и будущего роста. Главное — не бояться заглядывать «под капот» и использовать встроенные инструменты мониторинга и анализа.
- PostgreSQL использует процессную модель и MVCC для обеспечения параллелизма и надёжности.
- Правильная настройка параметров памяти и autovacuum критична для стабильной работы.
- Выбор типа индекса должен основываться на характере запросов и типе данных.
- Репликация позволяет обеспечить отказоустойчивость и масштабирование на чтение.
- Мониторинг и профилирование — основа эффективного управления базой данных.
⚠️ Дисклеймер — нажмите, чтобы развернуть
Материалы, опубликованные в разделе «Блог» на сайте RU DESIGN SHOP (rudesignshop.ru), носят исключительно информационный и ознакомительный характер и не являются руководством к действию, финансовой рекомендацией, медицинской услугой, ветеринарным назначением либо рекламой товаров и услуг, включая азартные игры. Публикации не содержат призывов к участию в азартных играх и не направлены на продвижение соответствующих операторов.
Безопасность применения товаров и веществ: при использовании строительных материалов, бытовой химии, пестицидов и агрохимикатов необходимо строго следовать инструкциям производителя и действующему законодательству Российской Федерации, включая Федеральный закон РФ от 19.07.1997 № 109-ФЗ «О безопасном обращении с пестицидами и агрохимикатами».
Упоминание товарных знаков, брендов и организаций носит исключительно информационный характер и не означает наличие партнёрских отношений или одобрения со стороны правообладателей.
Материалы, содержащие сведения о медицинских, ветеринарных или косметических средствах, представлены в справочных целях и не являются медицинской консультацией или назначением. Перед применением рекомендуется обратиться к врачу, ветеринарному специалисту или иному сертифицированному профессионалу.
Возрастные ограничения: материалы, содержащие сведения о продукции категории 18+, включая алкоголь или азартные игры, предназначены исключительно для совершеннолетней аудитории и публикуются в информационных целях.
Правовая ответственность: решения, принятые на основе опубликованной информации, пользователь принимает самостоятельно и на свой риск; редакция и авторы несут ответственность в пределах, установленных законодательством Российской Федерации.
Редакция не допускает публикаций, содержащих пропаганду экстремизма, терроризма, наркотических средств или суицида; подобные материалы подлежат немедленному удалению.
Упоминание организаций с ограниченным статусом: компания Meta Platforms Inc. (социальные сети Facebook и Instagram) признана экстремистской организацией решением суда РФ, её деятельность запрещена на территории Российской Федерации; любые упоминания приводятся исключительно в информационных целях.
Авторские права и источники: информация собирается из открытых источников; её актуальность указывается на дату публикации и может изменяться.
Изображения и иллюстрации используются на условиях, разрешённых правообладателями. При возникновении претензий редакция готова оперативно рассмотреть обращение и внести необходимые изменения.
Персональные данные и cookies: сайт использует cookies и обрабатывает персональные данные пользователей в соответствии с Федеральным законом № 152-ФЗ «О персональных данных» и Политикой конфиденциальности RU DESIGN SHOP.
Мнения авторов могут не совпадать с позицией государственных органов или коммерческих организаций, упомянутых в материалах.
РЕКОМЕНДУЕМ
Товары от российских производителей
Светильник Eclipse Type Wall Forstlight
Диапазон цен: 14830 руб. – 36930 руб.
Люстра Opulent Seven GLODE
Диапазон цен: 27000 руб. – 28500 руб.